1. 增加分段TTS功能
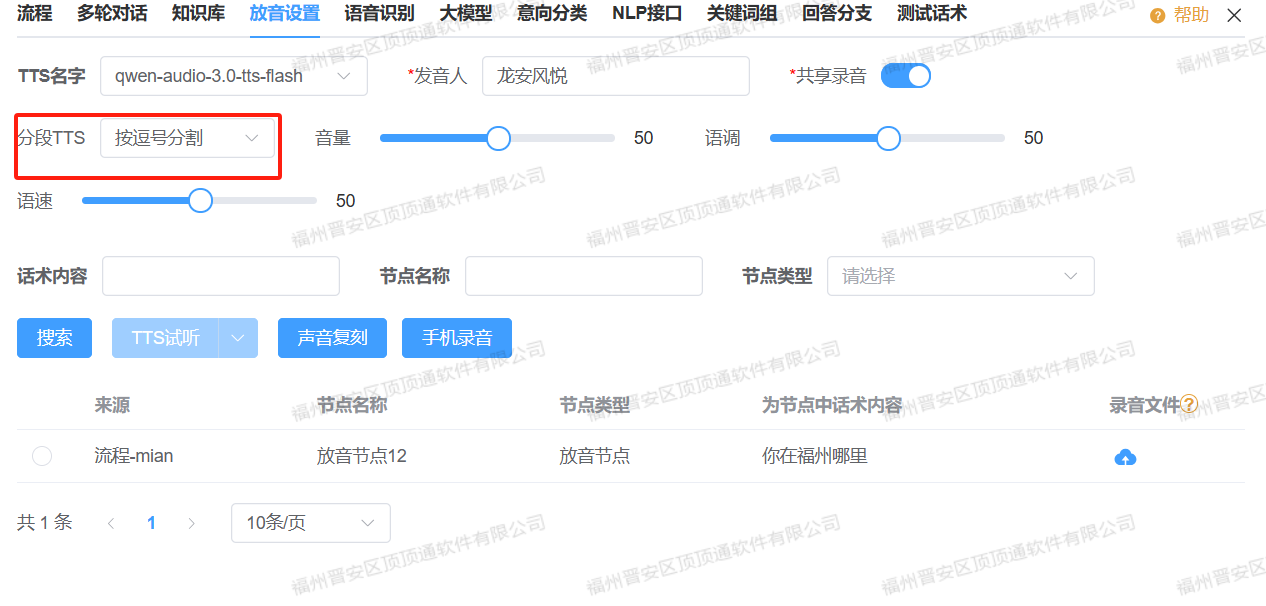
开启分段TTS可以提升AI响应速度并降低成本;按句号或逗号分割语句有助于优化缓存。
按句号分割:遇到
.。!?就分割按逗号分割:遇到
,,.。!?就分割
比如你好,你是谁啊?有什么事情呢!
按句号分割: 你好,你是谁啊? 有什么事情呢!
按逗号分割:你好, 你是谁啊? 有什么事情呢!
按逗号分割可以更充分的利用TTS缓存,有的TTS按句号分割会朗读的更有感情。
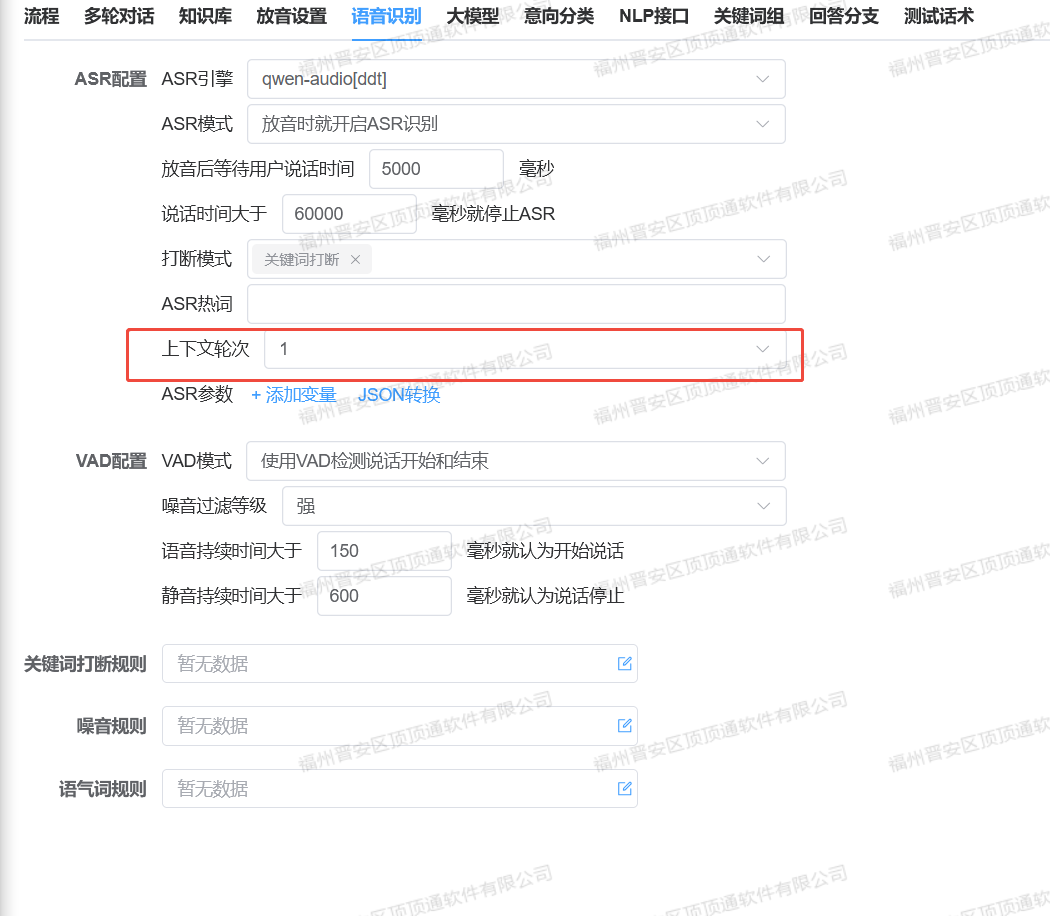
2. 增加支持对话内容提交给ASR引擎优化识别结果
目前只适配了Qwen-Audio-ASR
3. 添加对 Qwen-Audio-ASR和Qwen-Audio-TTS支持
通义千问实时语音合成Qwen-Audio-TTS 支持复刻 支持流式合成
模型说明: https://help.aliyun.com/zh/model-studio/tts-model
使用指南:https://help.aliyun.com/zh/model-studio/realtime-tts-user-guide
音色: 有500个音色
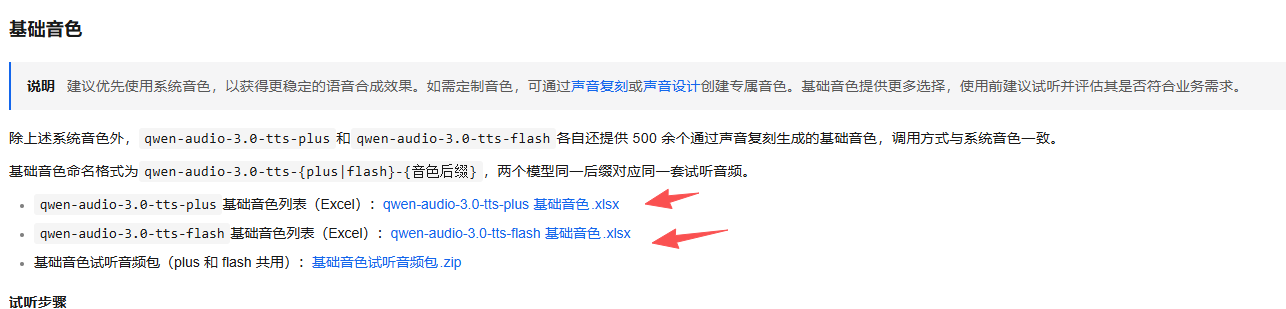
接口文档:https://help.aliyun.com/zh/model-studio/qwen-audio-tts-api
配置模板:
{
        "engine": "qwen-audio-3.1-tts-flash", //支持 qwen-audio-3.0-tts-plus、qwen-audio-3.0-tts-flash
        "language_hints": "zh",
        "context": "",//instruction设置指令,例如“语速较快,带有明显的上扬语调,适合介绍时尚产品。
        "type": "dashscope",
        "key": "", //获取APIKEY 请看 https://help.aliyun.com/zh/model-studio/developer-reference/get-api-key
        /*
        "hot_fix": {"pronunciation": [{"天气": "tian1 qi4"}],"replace": [{"今天": "金天"}]},
         "enable_ssml":false,//开启后就不能流式合成
        */

}
实时语音识别 Qwen-Audio-ASR-Streaming
接口文档:https://docs.bailian.console.aliyun.com/zh/model-studio/qwen-audio-asr-streaming-client-events
模型说明:https://docs.bailian.console.aliyun.com/zh/model-studio/asr-model
使用指南:https://docs.bailian.console.aliyun.com/zh/model-studio/real-time-speech-recognition-user-guide
模型说明:
qwen-audio-3.0-asr-flash-streaming:https://docs.bailian.console.aliyun.com/zh/model-studio/qwen-audio-3-0-asr-flash-streaming
qwen-audio-3.1-asr-flash-streaming:https://docs.bailian.console.aliyun.com/zh/model-studio/qwen-audio-3-1-asr-flash-streaming
配置模板:
{
        "engine": "qwen-audio-3.1-asr-flash-streaming", //qwen-audio-3.0-asr-flash-streaming 注意:3.0按时间收费3.1按token收费
        "type": "dashscope",
        "key": "", //获取APIKEY 请看 https://help.aliyun.com/zh/model-studio/developer-reference/get-api-key
        /*
        "vocabulary_id":"",//预编译热词列表 ID。
        "semantic_punctuation_enabled":false,//是否启用语义断句。
        "multi_threshold_mode_enabled":false,//是否启用多阈值模式。启用后可防止 VAD 断句切割过长。
        "speech_noise_threshold":0,//语音与噪音的判定阈值,用于调整语音活动检测(VAD)的灵敏度。
        "special_word_filter":"",//指定在语音识别过程中需要处理的敏感词,并支持对不同敏感词设置不同的处理方式
        */

}